z-image
资源介绍
基于单流扩散 Transformer 的高效图像生成基础模型
Z-Image
Z-Image 是一个强大且高效的图像生成模型系列,参数量为 6B。目前包含四个变体:
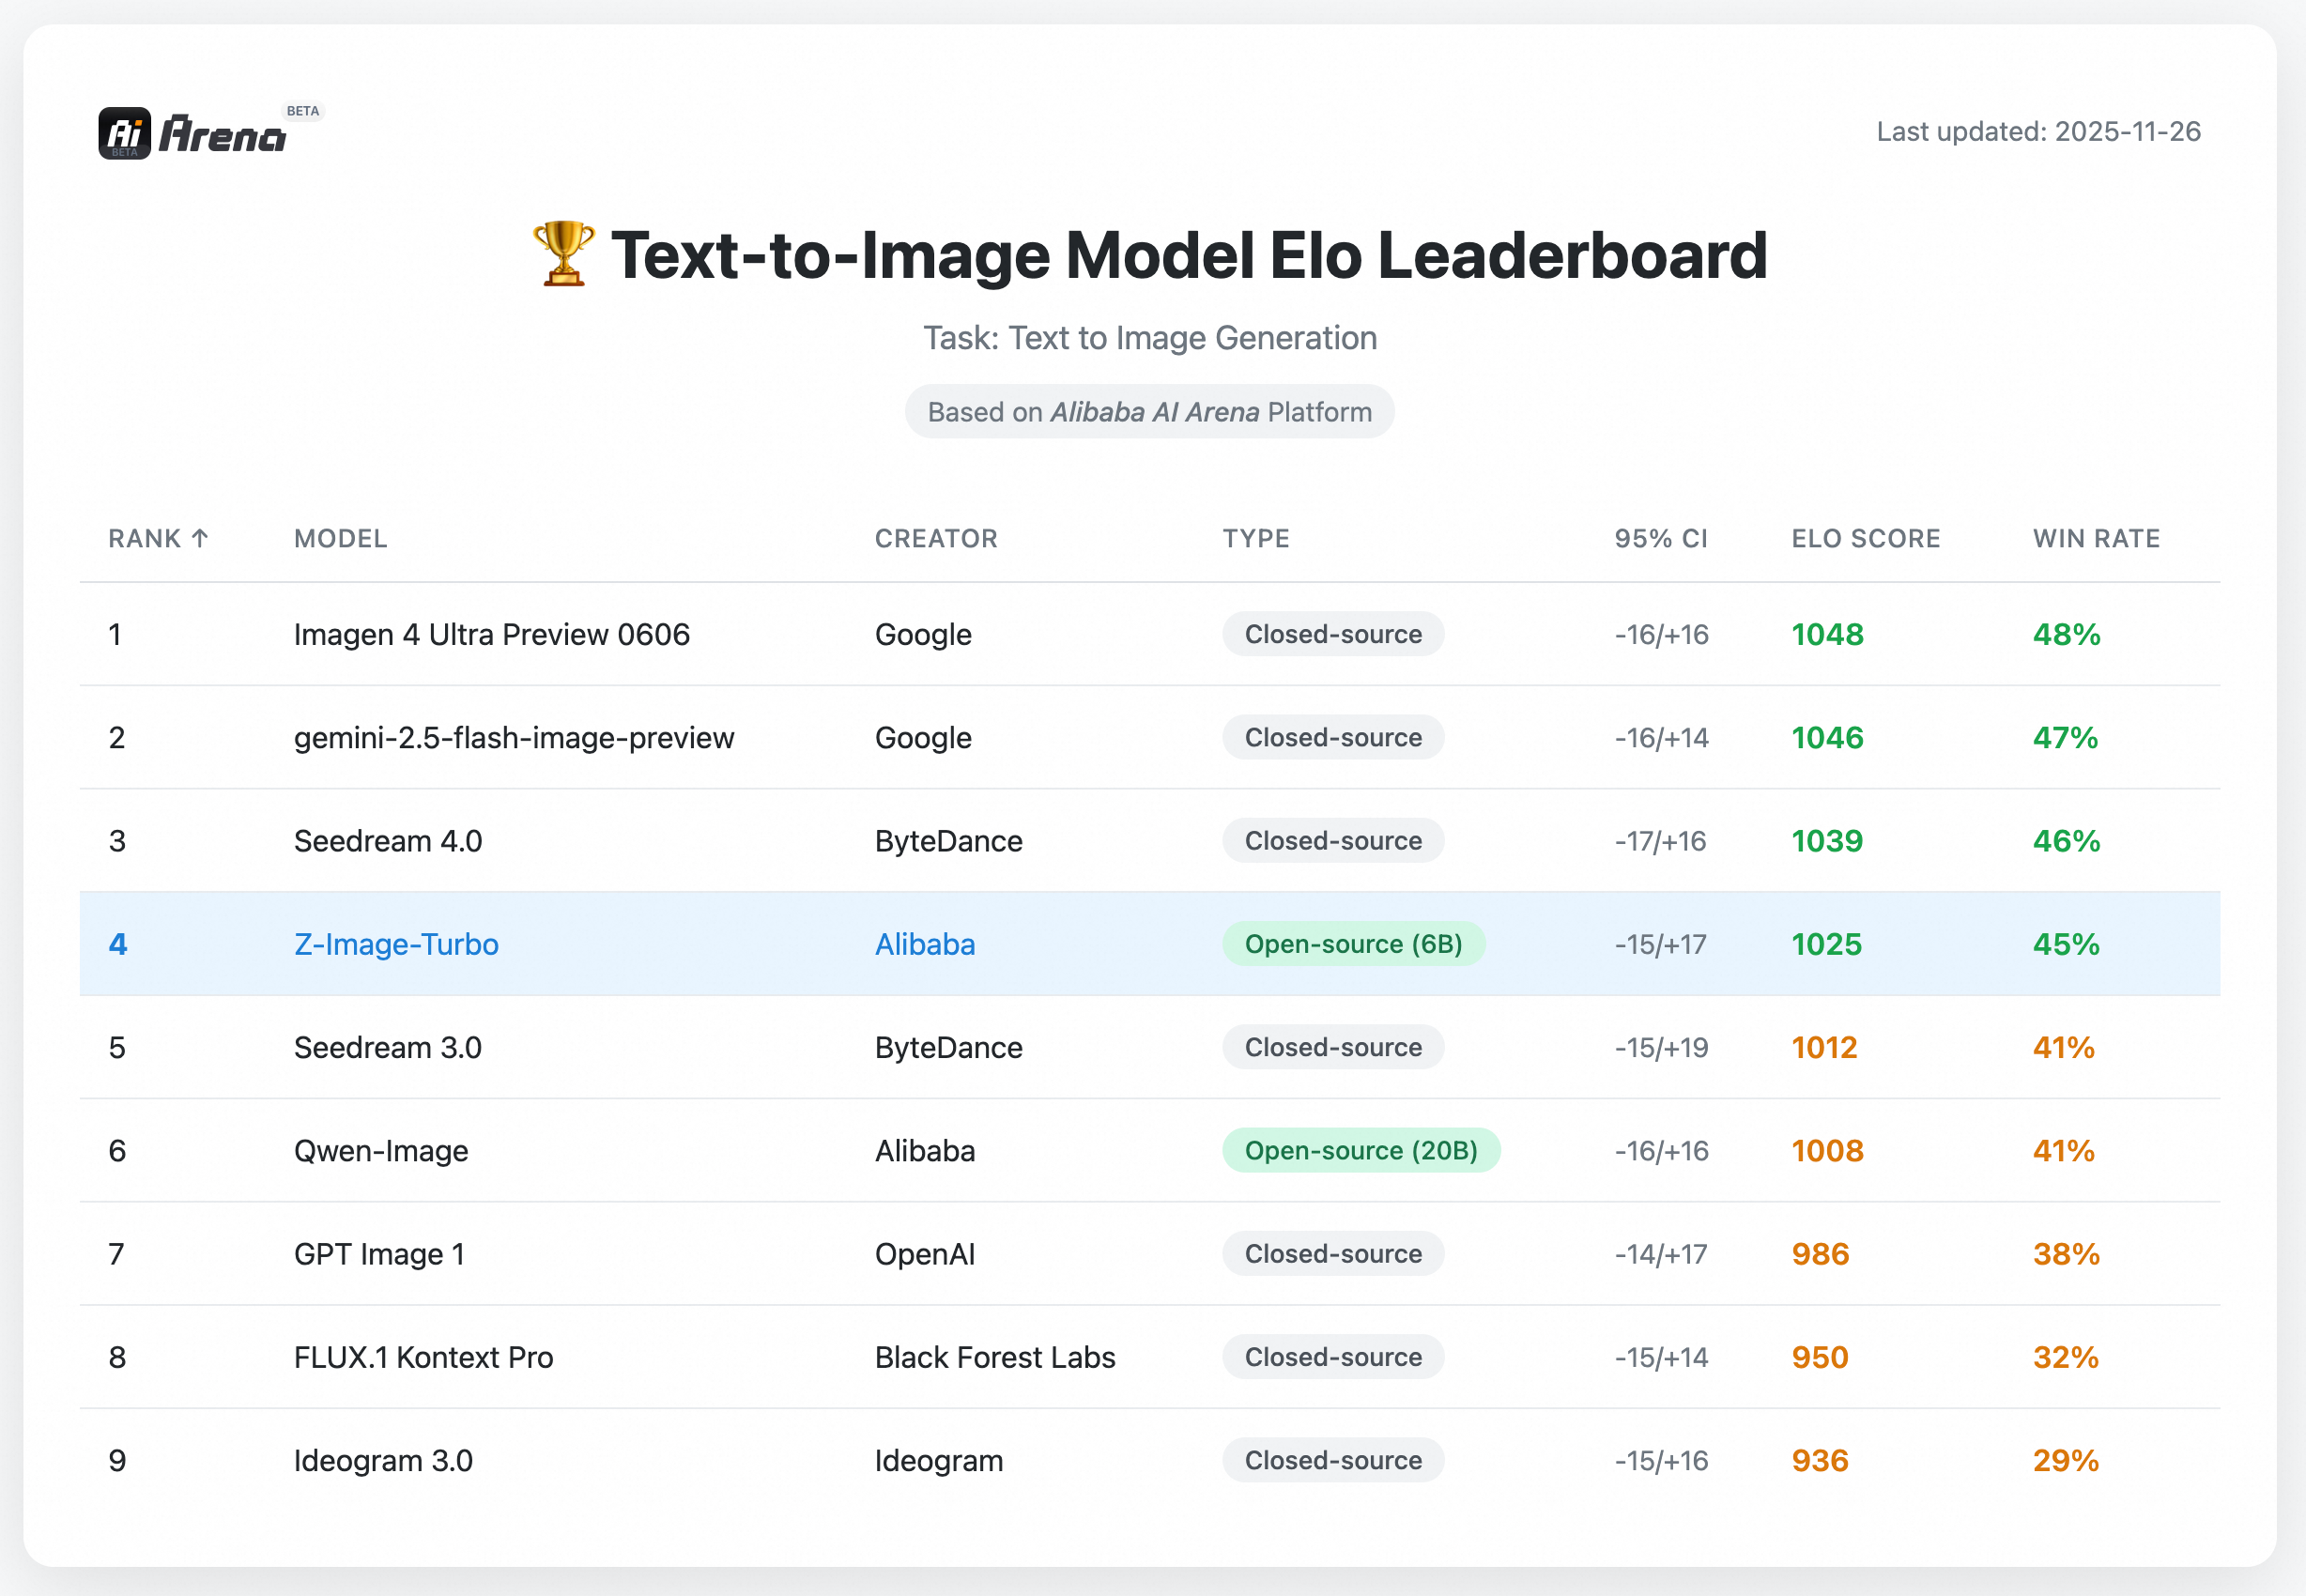
- Z-Image-Turbo – Z-Image 的蒸馏版本,仅需 8 次函数评估(NFEs) 即可达到或超越主流竞品性能。在企业级 H800 GPU 上可实现亚秒级推理延迟,并可在 16G 显存的消费级设备 上轻松运行。该模型在逼真图像生成、双语文本渲染(英文与中文)以及强指令遵循能力方面表现卓越。
- Z-Image – Z-Image-Turbo 背后的基础模型。Z-Image 专注于 高质量生成、丰富的美学表现、强大的多样性 和 可控性,非常适合创意生成、微调 及下游开发。它支持广泛的美术风格、有效的负向提示(negative prompting),并在人物身份、姿态、构图和布局等方面展现出高度多样性。
- Z-Image-Omni-Base – 一款通用型基础模型,同时支持 图像生成与编辑任务。通过发布此检查点,我们旨在充分释放社区驱动的微调与定制化开发潜力,为开源社区提供最“原始”且多样化的起点。
- Z-Image-Edit – 在 Z-Image 基础上专门针对图像编辑任务进行微调的变体。它支持富有创意的图生图生成,并具备出色的指令遵循能力,可根据自然语言提示实现精准编辑。
模型库
模型 | 预训练 | SFT | RL | 步数 | CFG | 任务 | 视觉质量 | 多样性 | 微调友好性 | Hugging Face | ModelScope |
|---|---|---|---|---|---|---|---|---|---|---|---|
Z-Image-Omni-Base | ✅ | ❌ | ❌ | 50 | ✅ | 生成 / 编辑 | 中等 | 高 | 容易 | 即将发布 | 即将发布 |
Z-Image | ✅ | ✅ | ❌ | 50 | ✅ | 生成 | 高 | 中等 | 容易 | ||
Z-Image-Turbo | ✅ | ✅ | ✅ | 8 | ❌ | 生成 | 极高 | 低 | 不适用 | ||
Z-Image-Edit | ✅ | ✅ | ❌ | 50 | ✅ | 编辑 | 高 | 中等 | 容易 | 即将发布 | 即将发布 |
效果展示
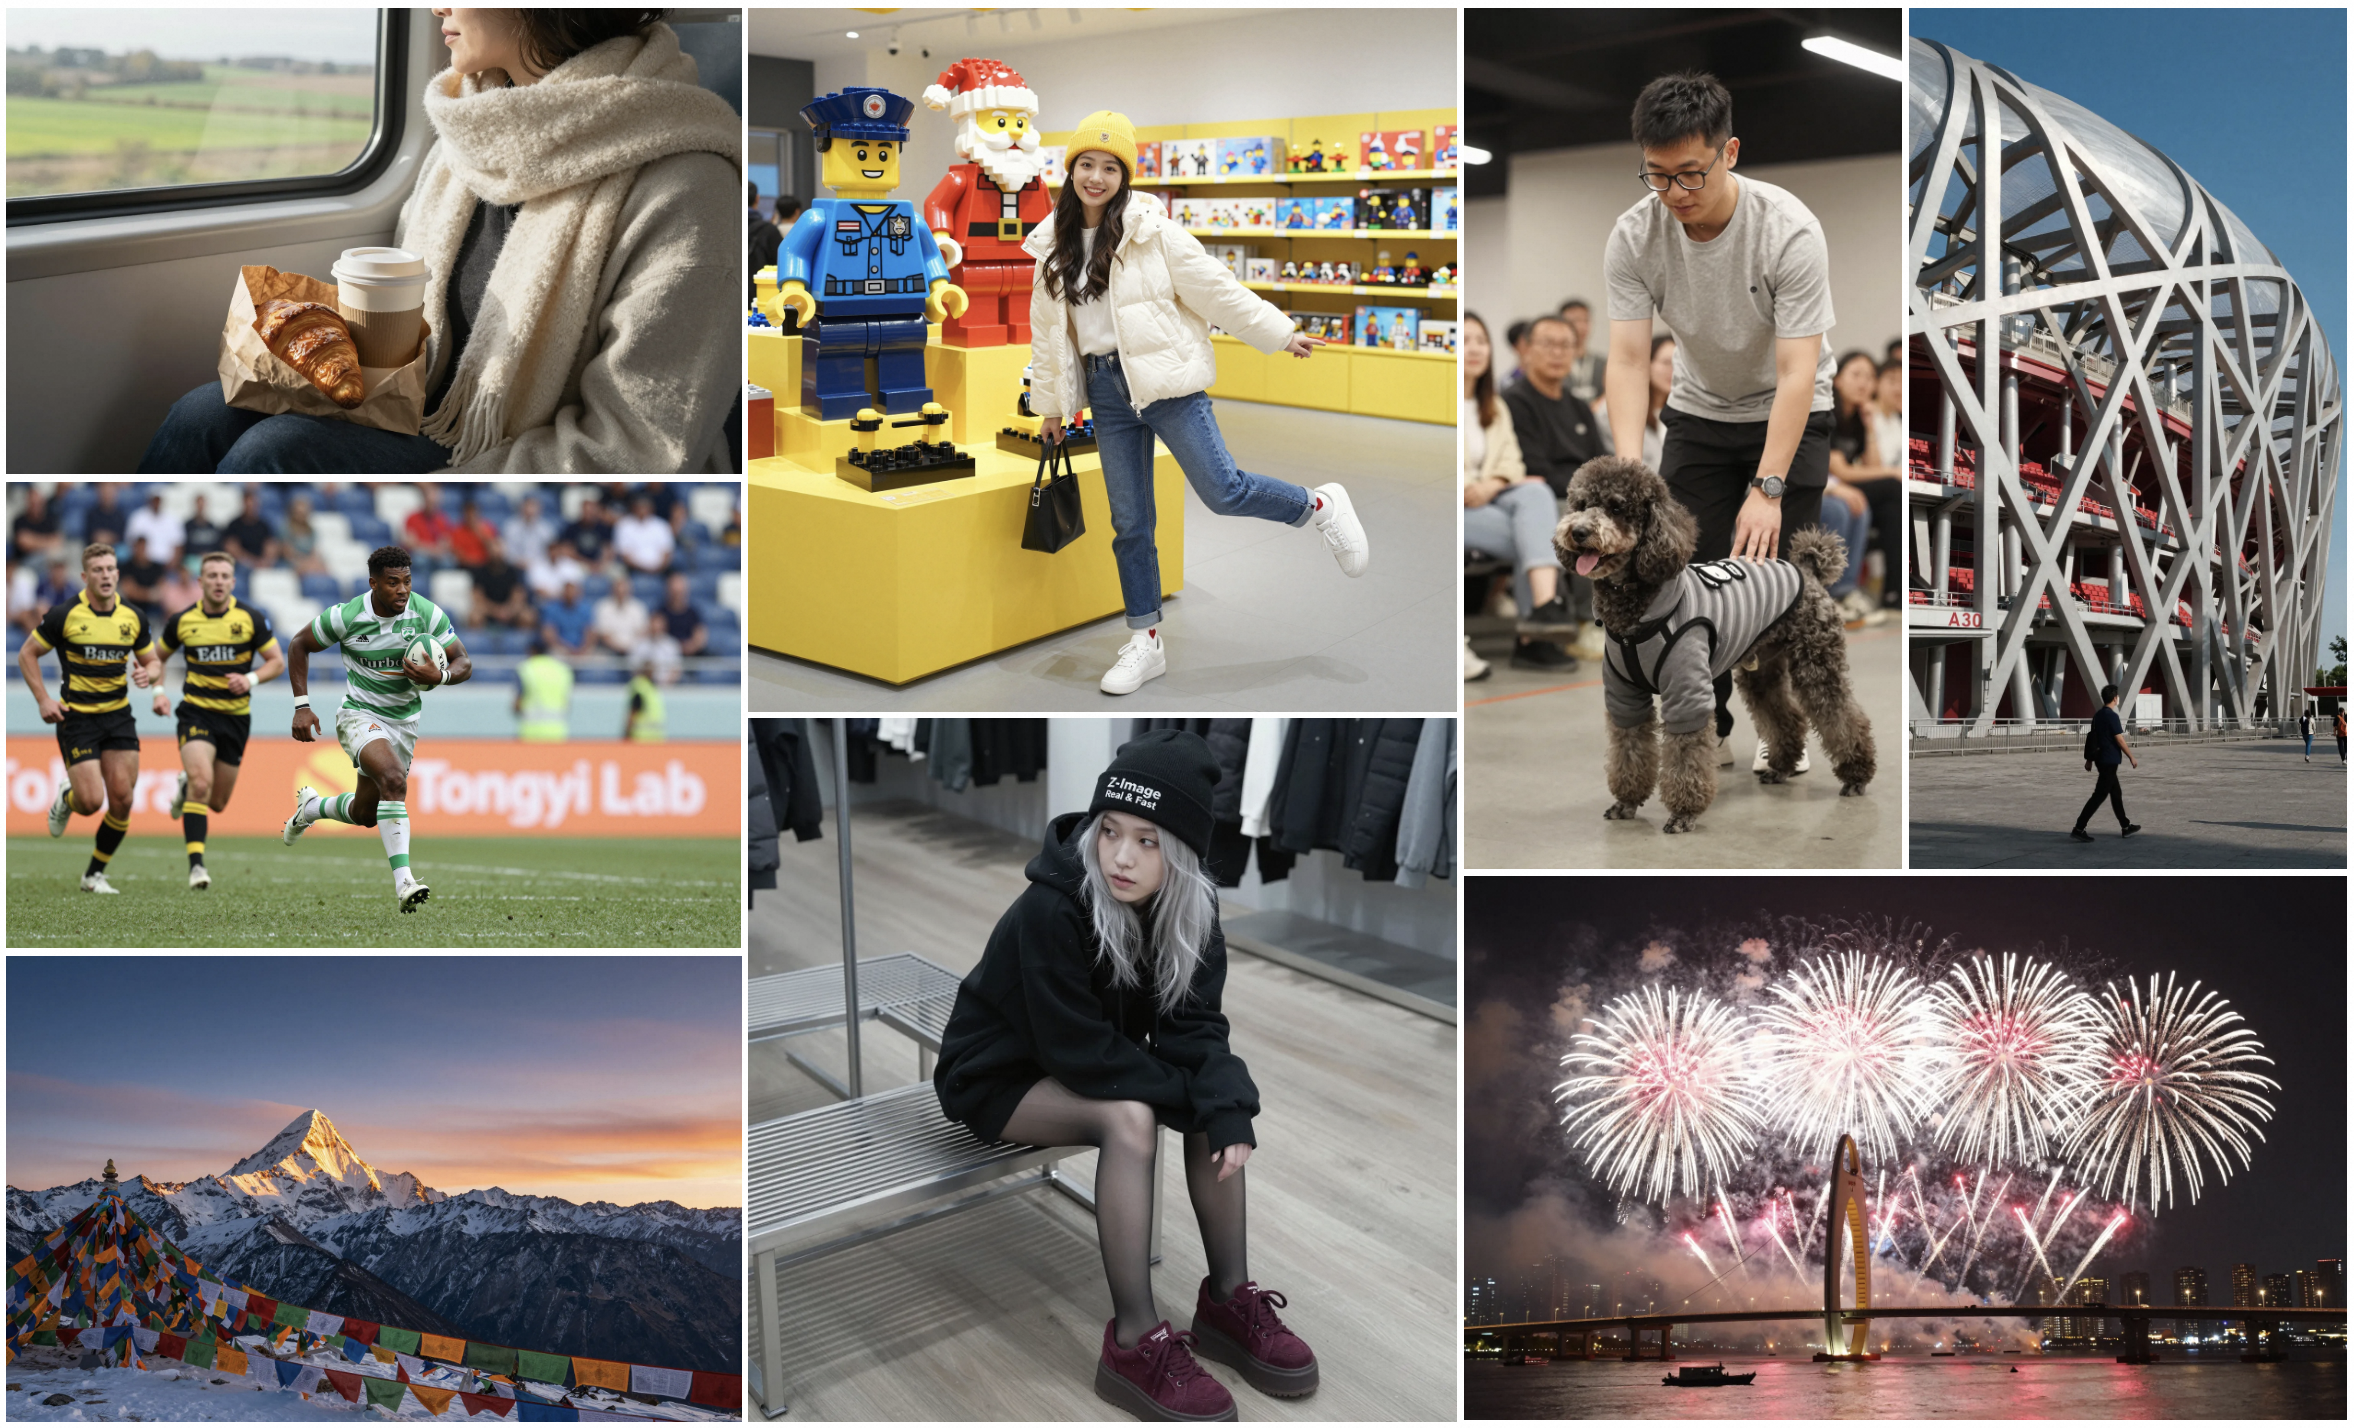
逼真画质:Z-Image-Turbo 在生成高度逼真的图像的同时,保持了出色的美学质量。
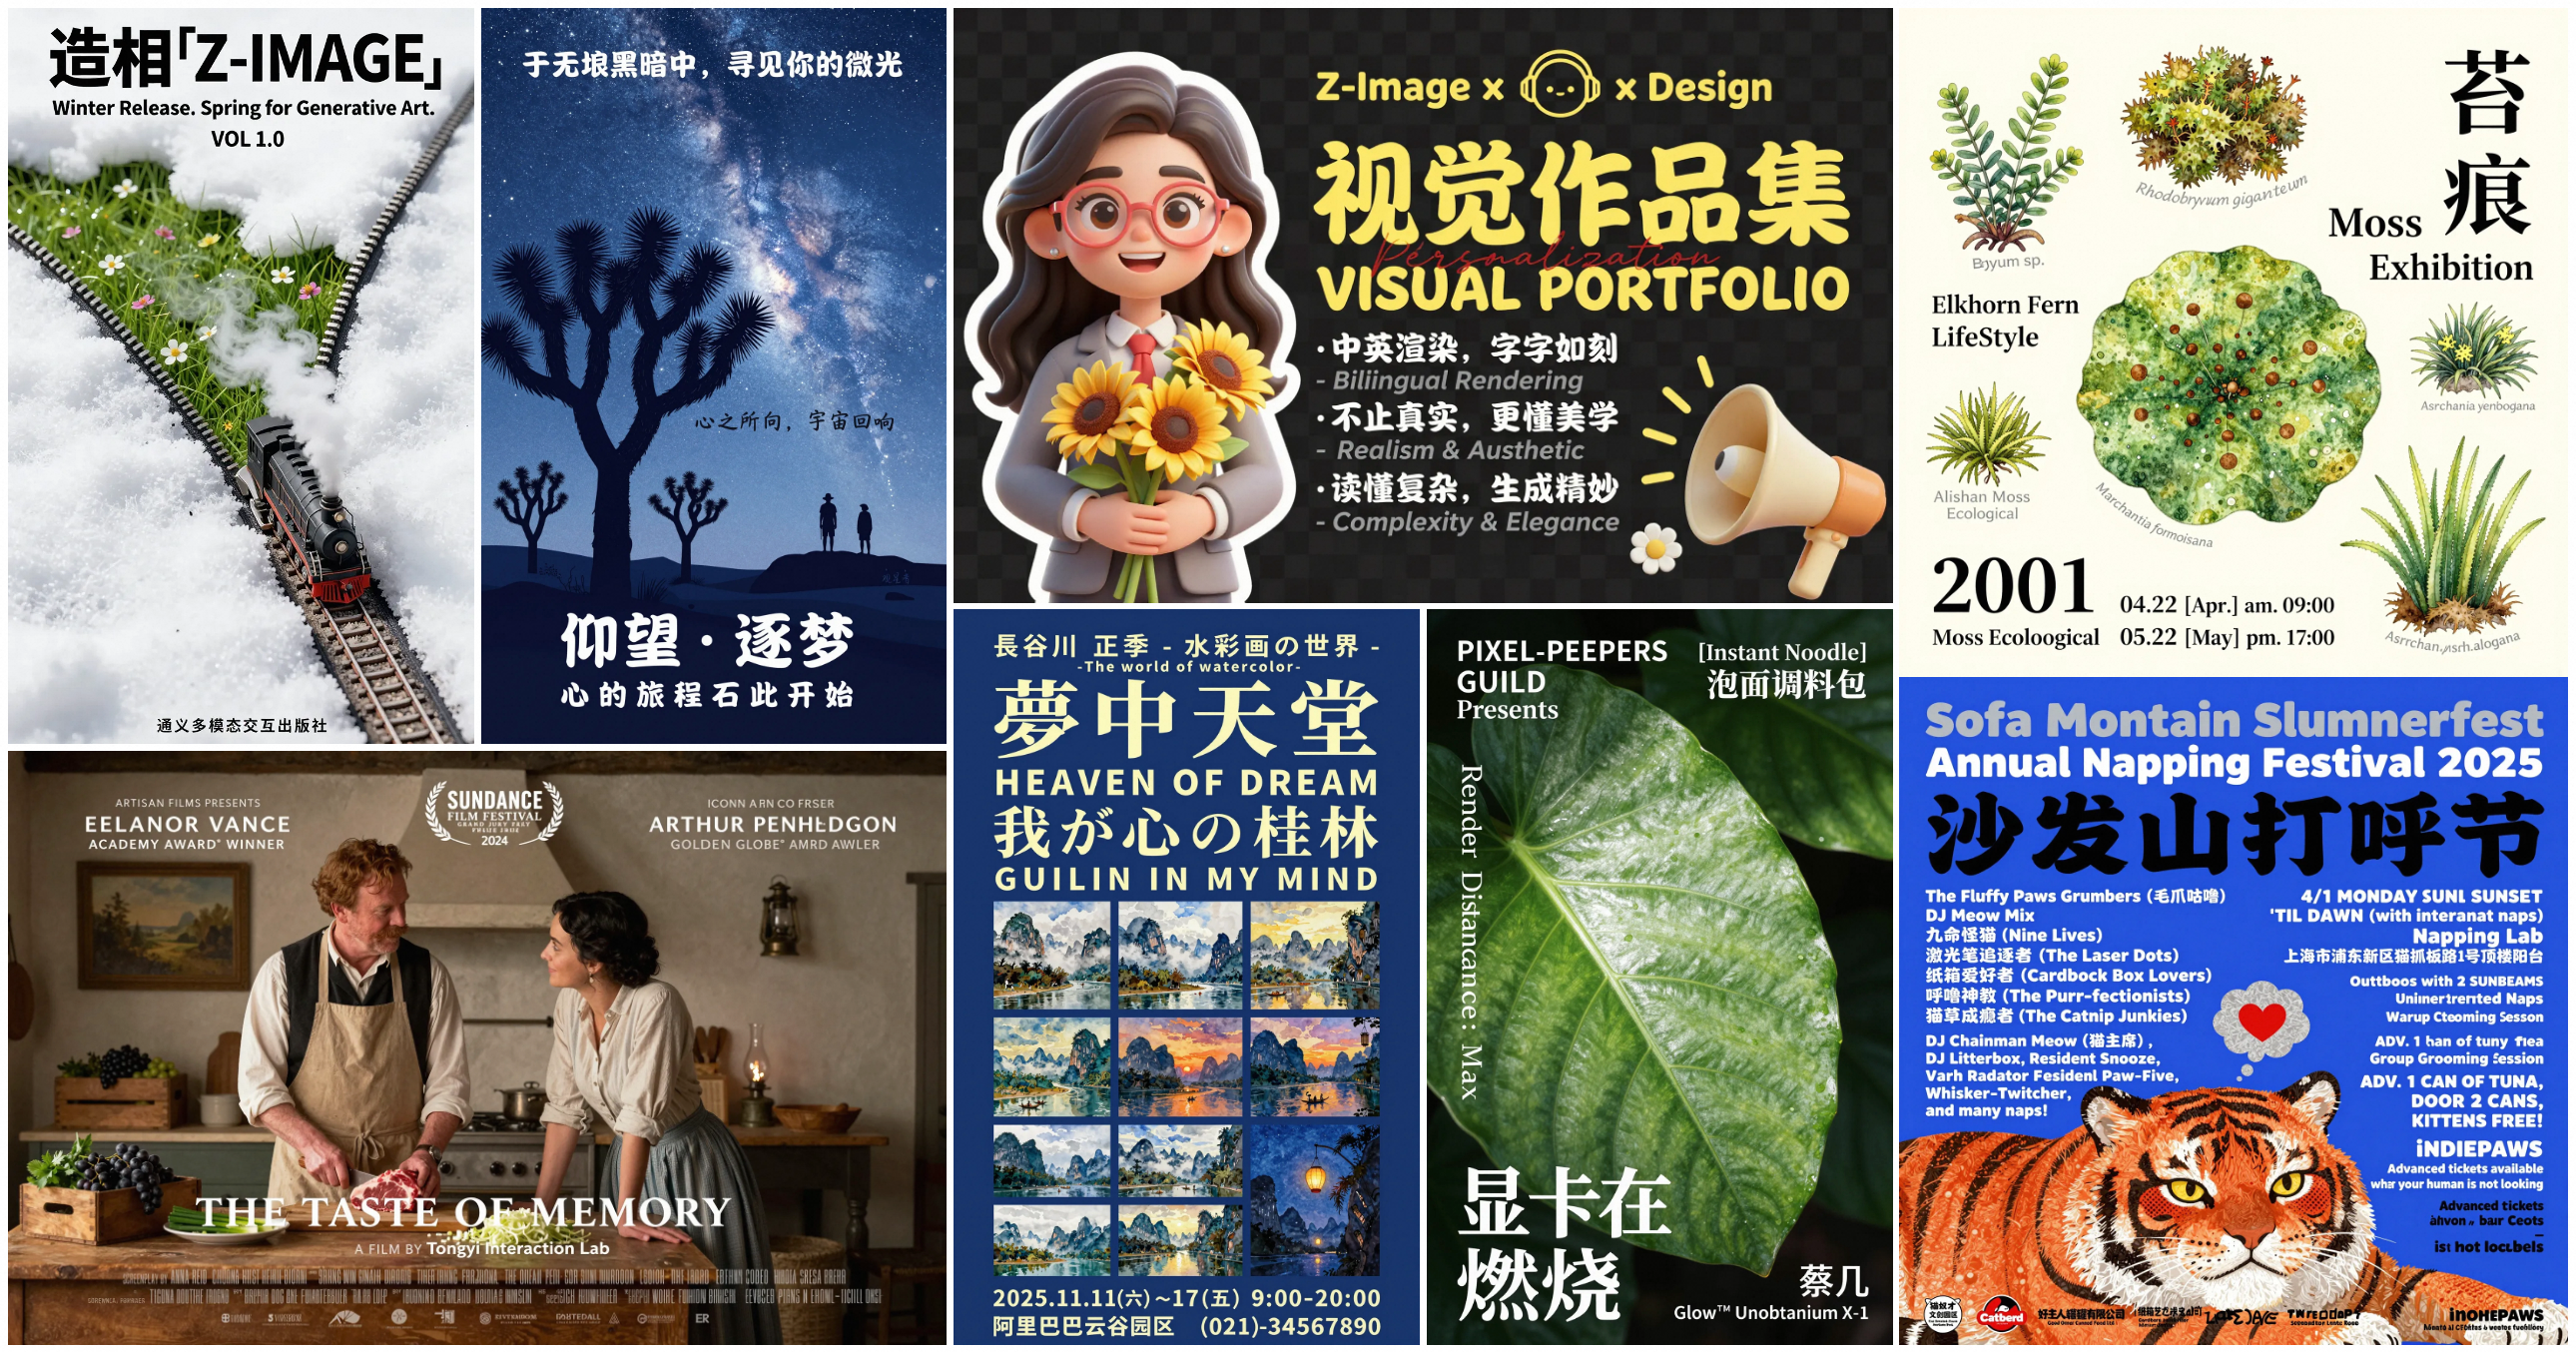
精准的双语文本渲染:Z-Image-Turbo 能够准确渲染复杂的中英文文本。
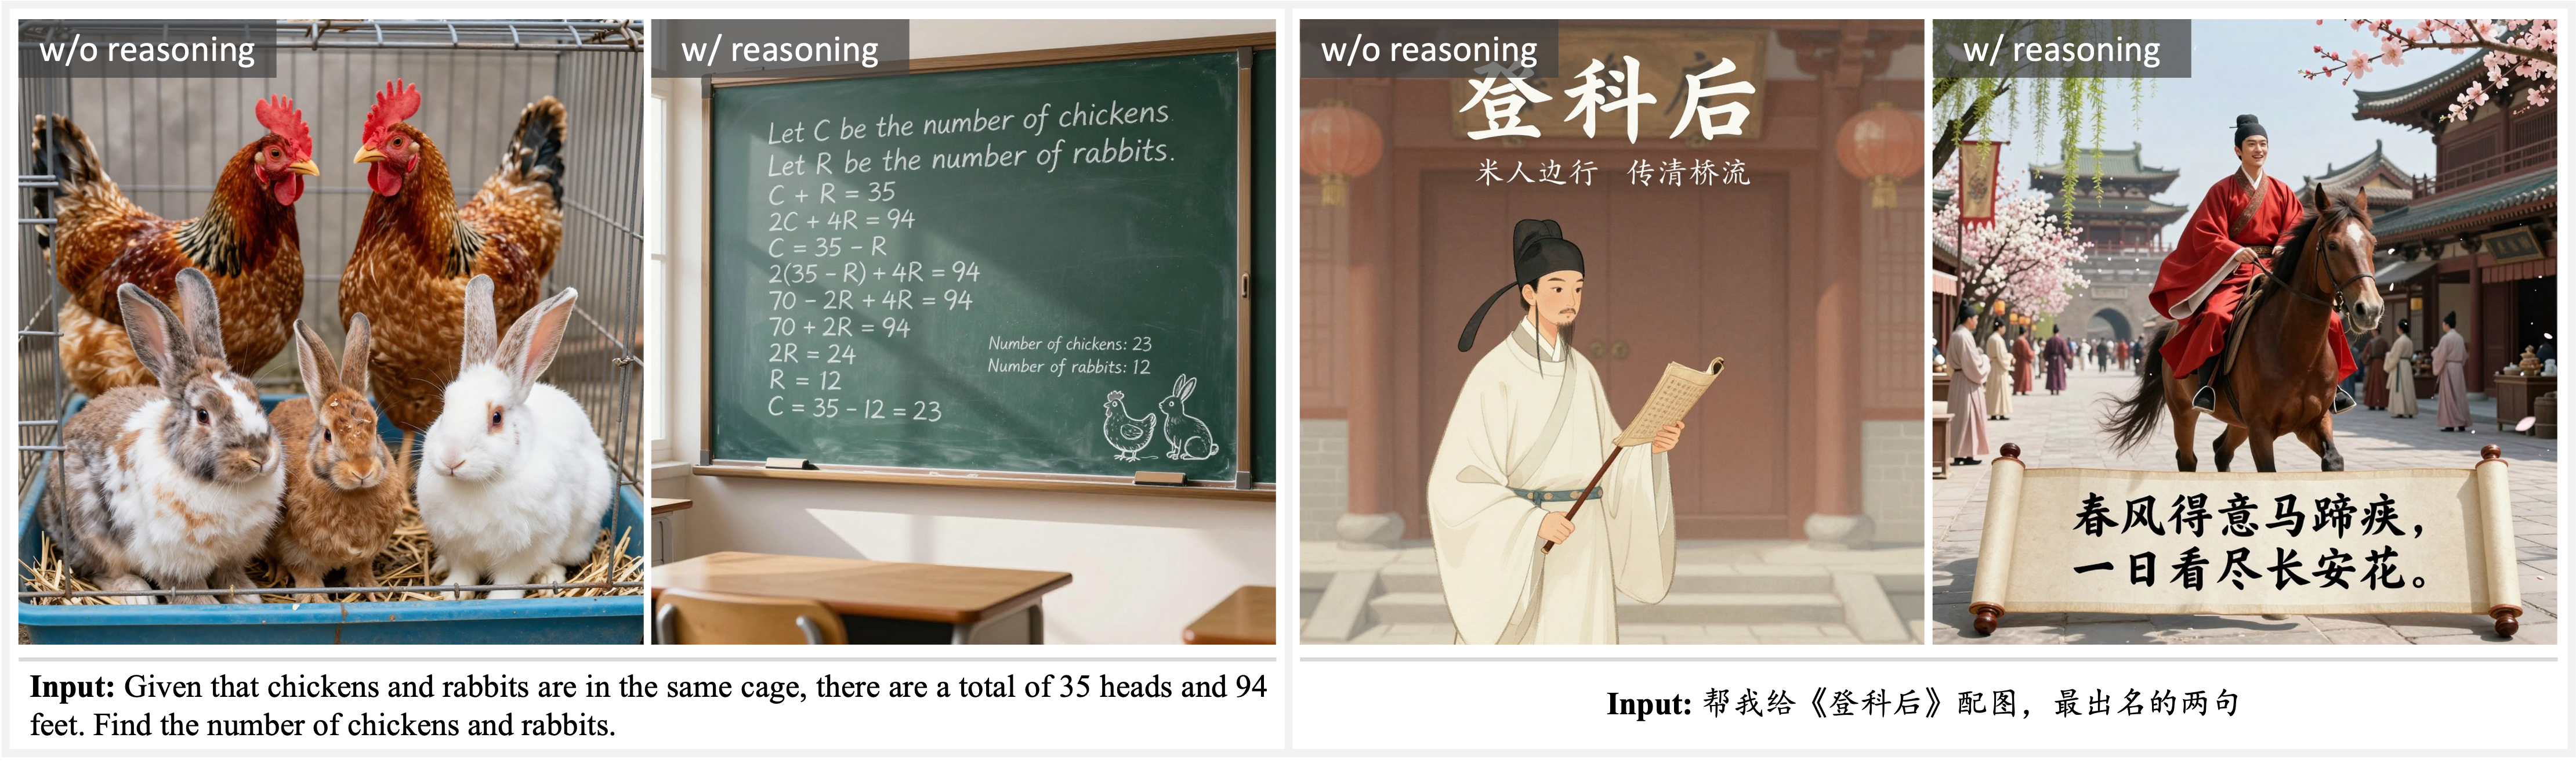
提示增强与推理能力:提示增强器(Prompt Enhancer)赋予模型推理能力,使其能够超越表面描述,深入挖掘底层的世界知识。
创意图像编辑:Z-Image-Edit 对中英双语编辑指令具有强大的理解能力,可实现富有想象力且灵活的图像变换。

模型架构
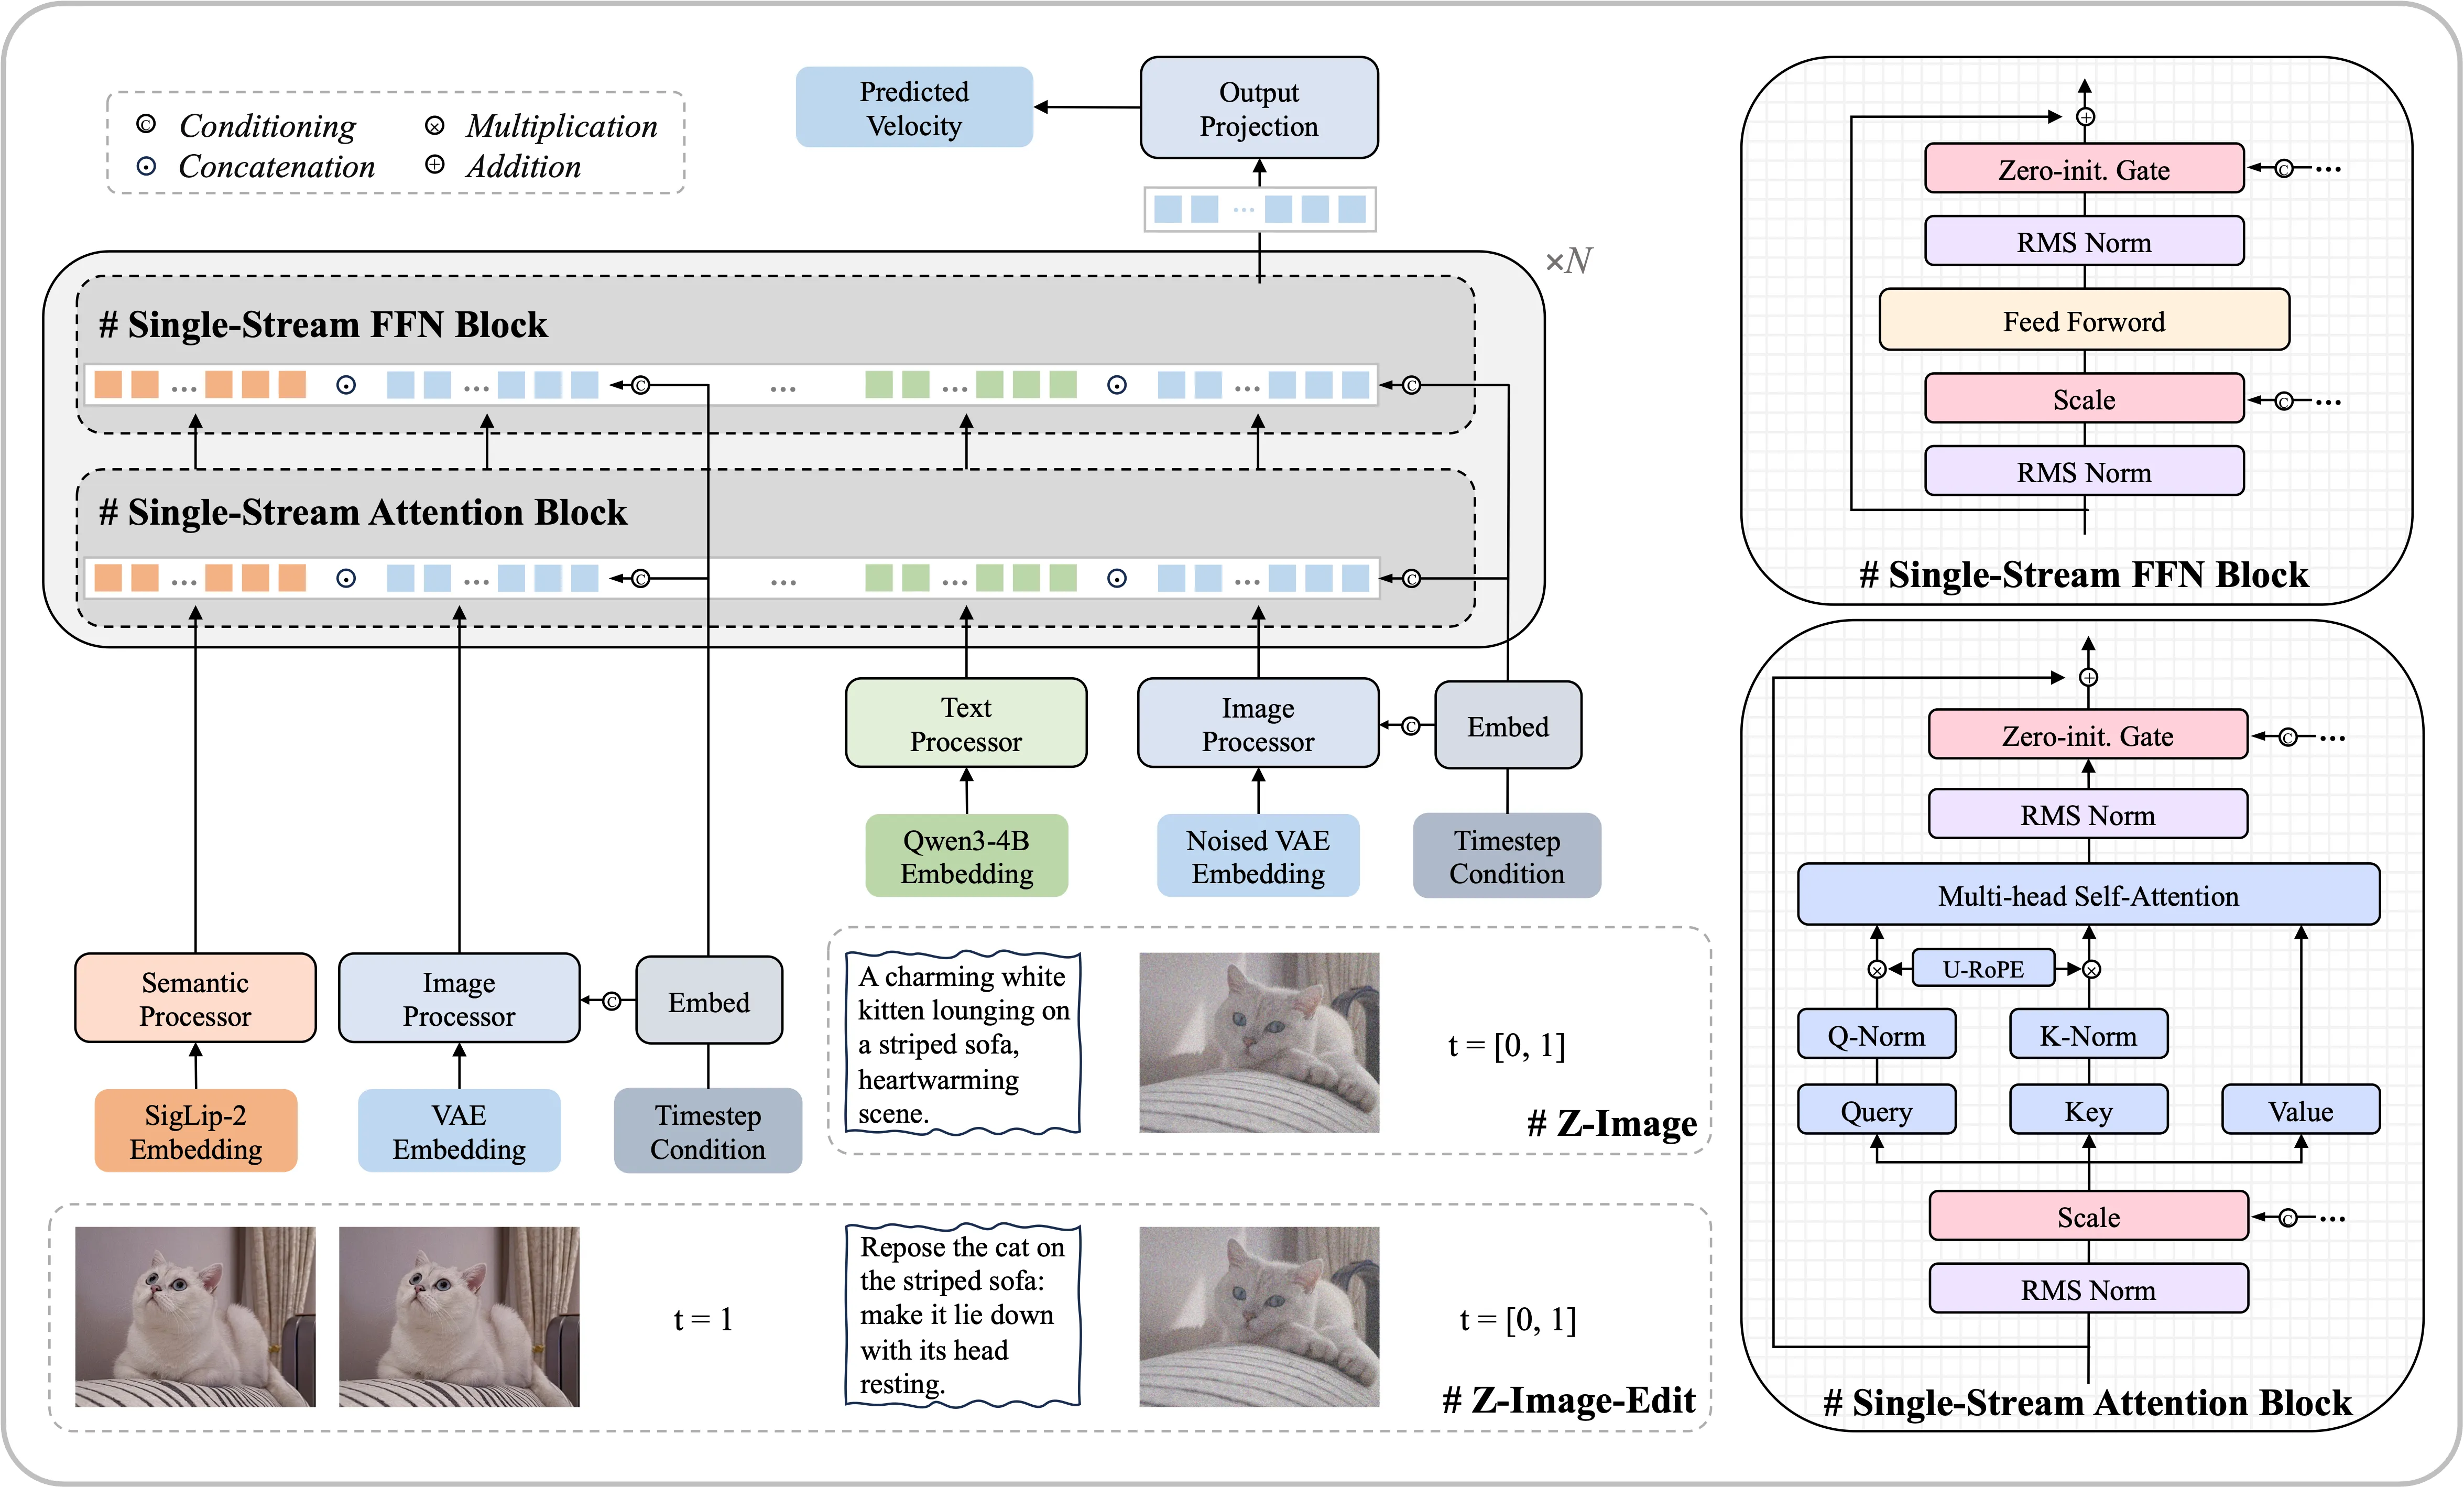
我们采用了 可扩展单流 DiT(S3-DiT)架构。在此架构中,文本、视觉语义 token 和图像 VAE token 在序列级别上进行拼接,形成统一的输入流,相比双流方法能最大化参数效率。
Decoupled-DMD:Z-Image 背后的加速魔法
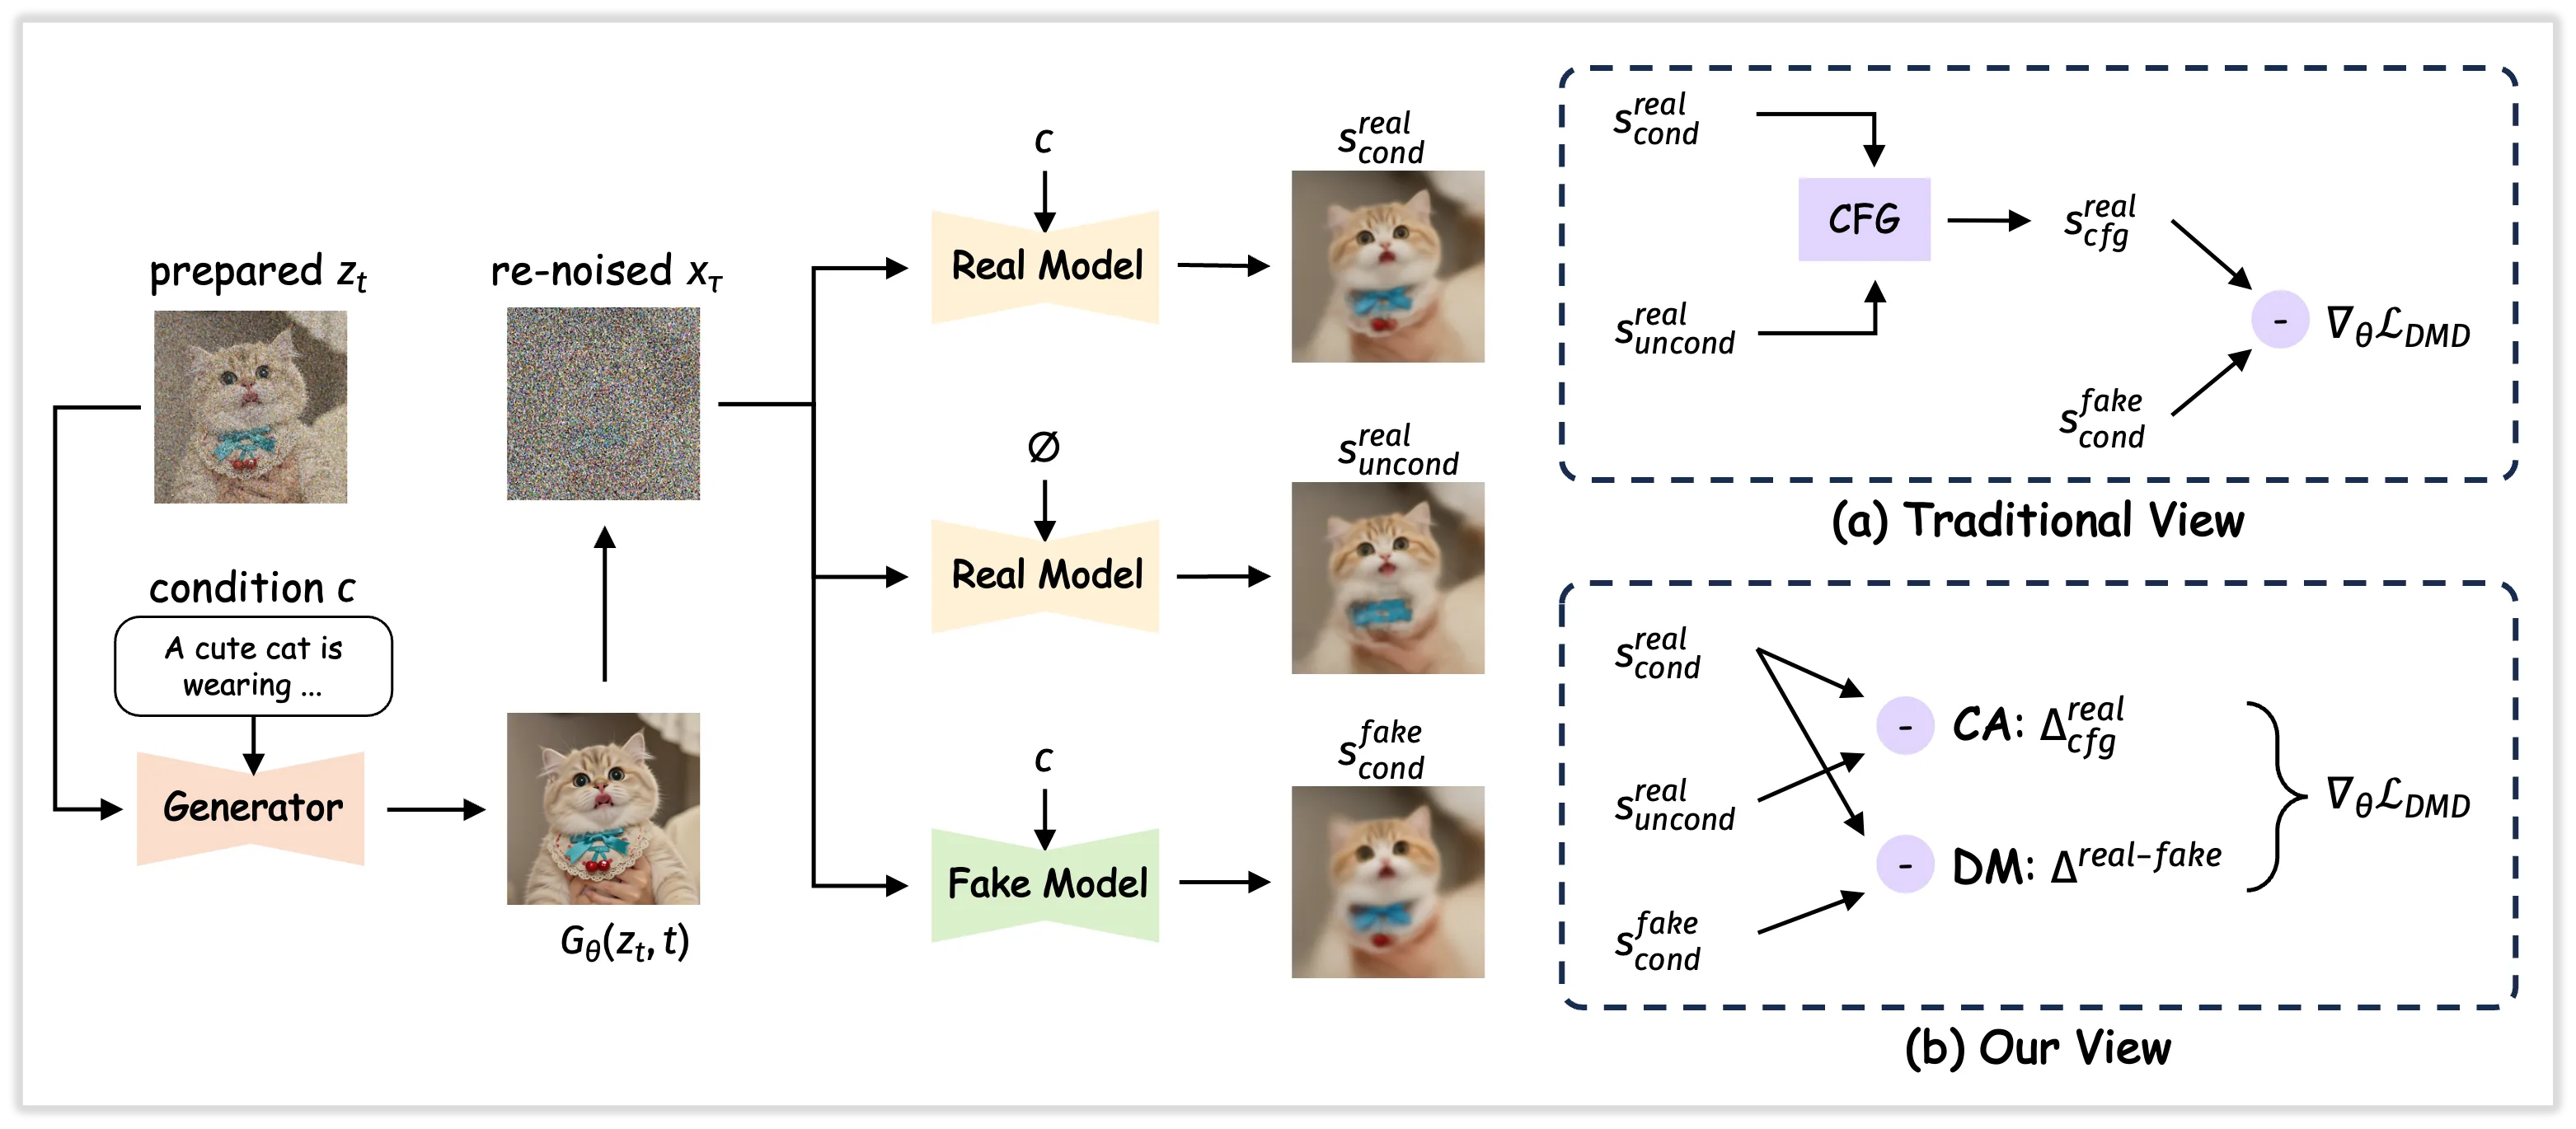
Decoupled-DMD 是赋能 8 步 Z-Image 模型的核心少步蒸馏算法。
我们在 Decoupled-DMD 中的核心洞察是:现有 DMD(Distribution Matching Distillation,分布匹配蒸馏)方法的成功源于两个独立但协同作用的机制:
- CFG 增强(CA):驱动蒸馏过程的主要引擎 ,这一因素在以往工作中很大程度上被忽视。
- 分布匹配(DM):更多地充当正则化器 ,确保生成结果的稳定性和质量。
通过识别并解耦这两种机制,我们得以分别对它们进行研究和优化。这最终促使我们开发出一种改进的蒸馏流程,显著提升了少步生成的性能。
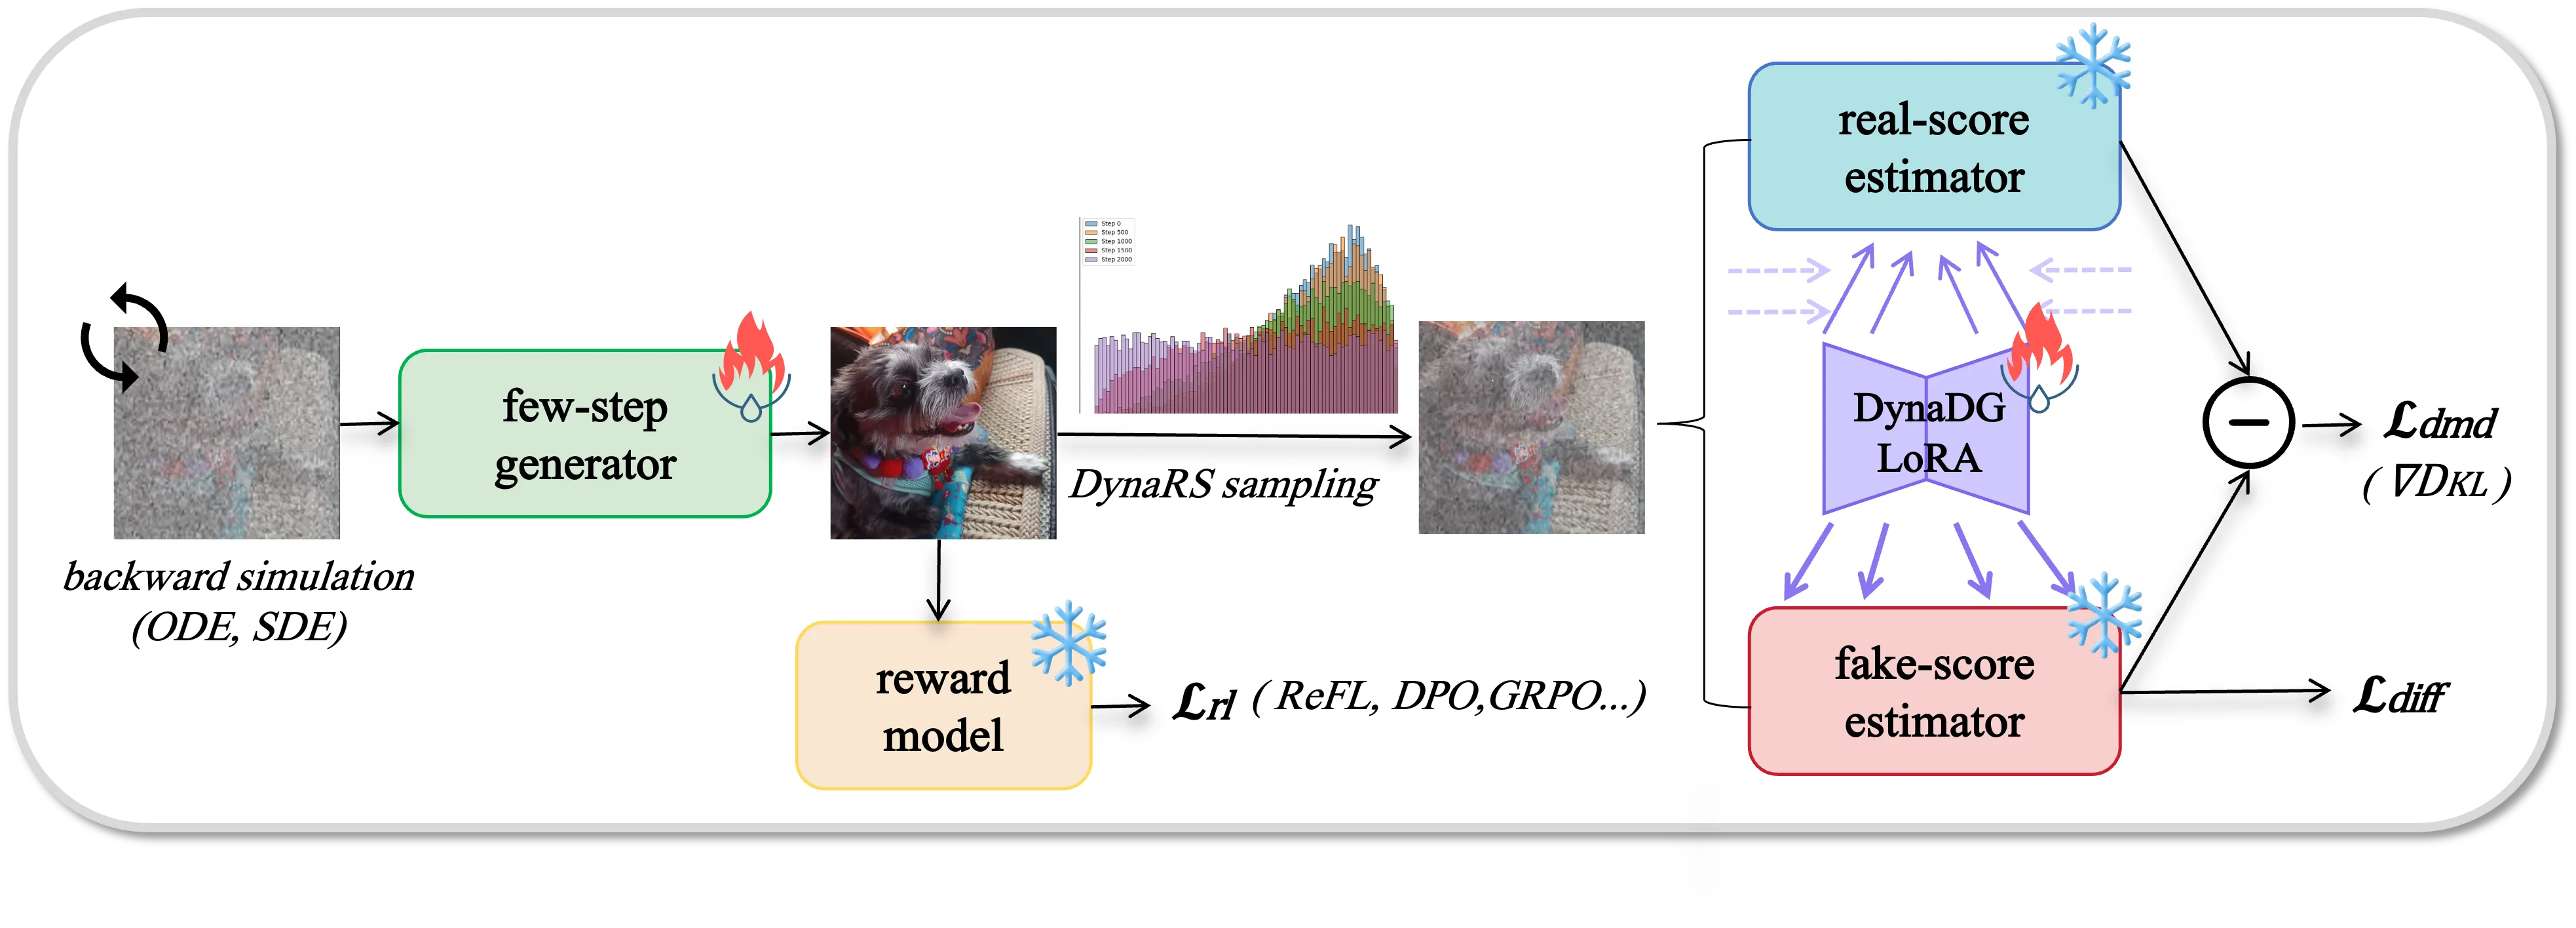
DMDR:融合 DMD 与强化学习
在 Decoupled-DMD 坚实基础之上,我们的 8 步 Z-Image 模型已展现出卓越的能力。为了进一步提升语义对齐、美学质量和结构一致性,并生成具有更丰富高频细节的图像,我们提出了 DMDR。
DMDR 背后的核心洞察是:在少步模型的后训练阶段,强化学习(RL)与分布匹配蒸馏(DMD)可以协同整合。我们证明了:
- RL 释放了 DMD 的性能潜力
- DMD 有效正则化了 RL
文件列表
Z-Image-turbo
文件 | 大小 | 更新时间 | 下载 |
|---|---|---|---|
vae/ae.safetensors | 319.8 MB | 2025-11-27 | |
text_encoders/qwen_3_4b.safetensors | 7.5 GB | 2025-11-27 | |
text_encoders/qwen_3_4b_fp4_mixed.safetensors | 3.2 GB | 2026-01-10 | |
text_encoders/qwen_3_4b_fp8_mixed.safetensors | 5.2 GB | 2026-01-10 | |
diffusion_models/z_image_turbo_bf16.safetensors | 11.5 GB | 2025-11-27 | |
loras/z_image_turbo_distill_patch_lora_bf16.safetensors | 151.5 MB | 2025-12-20 | |
diffusion_models/z_image_turbo_int8_convrot.safetensors | 5.8 GB | 2026-07-03 | |
diffusion_models/z_image_turbo_nvfp4.safetensors | 4.2 GB | 2026-01-06 |
将文件放置在以下文件夹中:
📂 ComfyUI/
├── 📂 models/
│ ├── 📂 diffusion_models/
│ │ ├── z_image_turbo_bf16.safetensors
│ │ ├── z_image_turbo_int8_convrot.safetensors
│ │ └── z_image_turbo_nvfp4.safetensors
│ ├── 📂 loras/
│ │ └── z_image_turbo_distill_patch_lora_bf16.safetensors
│ ├── 📂 text_encoders/
│ │ ├── qwen_3_4b.safetensors
│ │ ├── qwen_3_4b_fp4_mixed.safetensors
│ │ └── qwen_3_4b_fp8_mixed.safetensors
│ └── 📂 vae/
│ └── ae.safetensors
工作流示例:https://comfyanonymous.github.io/ComfyUI_examples/z_image/
Z-Image
原始模型仓库:https://huggingface.co/Tongyi-MAI/Z-Image
文件 | 大小 | 更新时间 | 下载 |
|---|---|---|---|
vae/ae.safetensors | 319.8 MB | 2026-01-27 | |
text_encoders/qwen_3_4b.safetensors | 7.5 GB | 2026-01-27 | |
text_encoders/qwen_3_4b_fp4_mixed.safetensors | 3.2 GB | 2026-01-28 | |
text_encoders/qwen_3_4b_fp8_mixed.safetensors | 5.2 GB | 2026-01-28 | |
diffusion_models/z_image_bf16.safetensors | 11.5 GB | 2026-01-27 | |
diffusion_models/z_image_int8_convrot.safetensors | 5.8 GB | 2026-07-03 |
将文件放置在以下文件夹中:
📂 ComfyUI/
├── 📂 models/
│ ├── 📂 diffusion_models/
│ │ ├── z_image_bf16.safetensors
│ │ └── z_image_int8_convrot.safetensors
│ ├── 📂 text_encoders/
│ │ ├── qwen_3_4b.safetensors
│ │ ├── qwen_3_4b_fp4_mixed.safetensors
│ │ └── qwen_3_4b_fp8_mixed.safetensors
│ ├── 📂 vae/
│ │ └── ae.safetensors